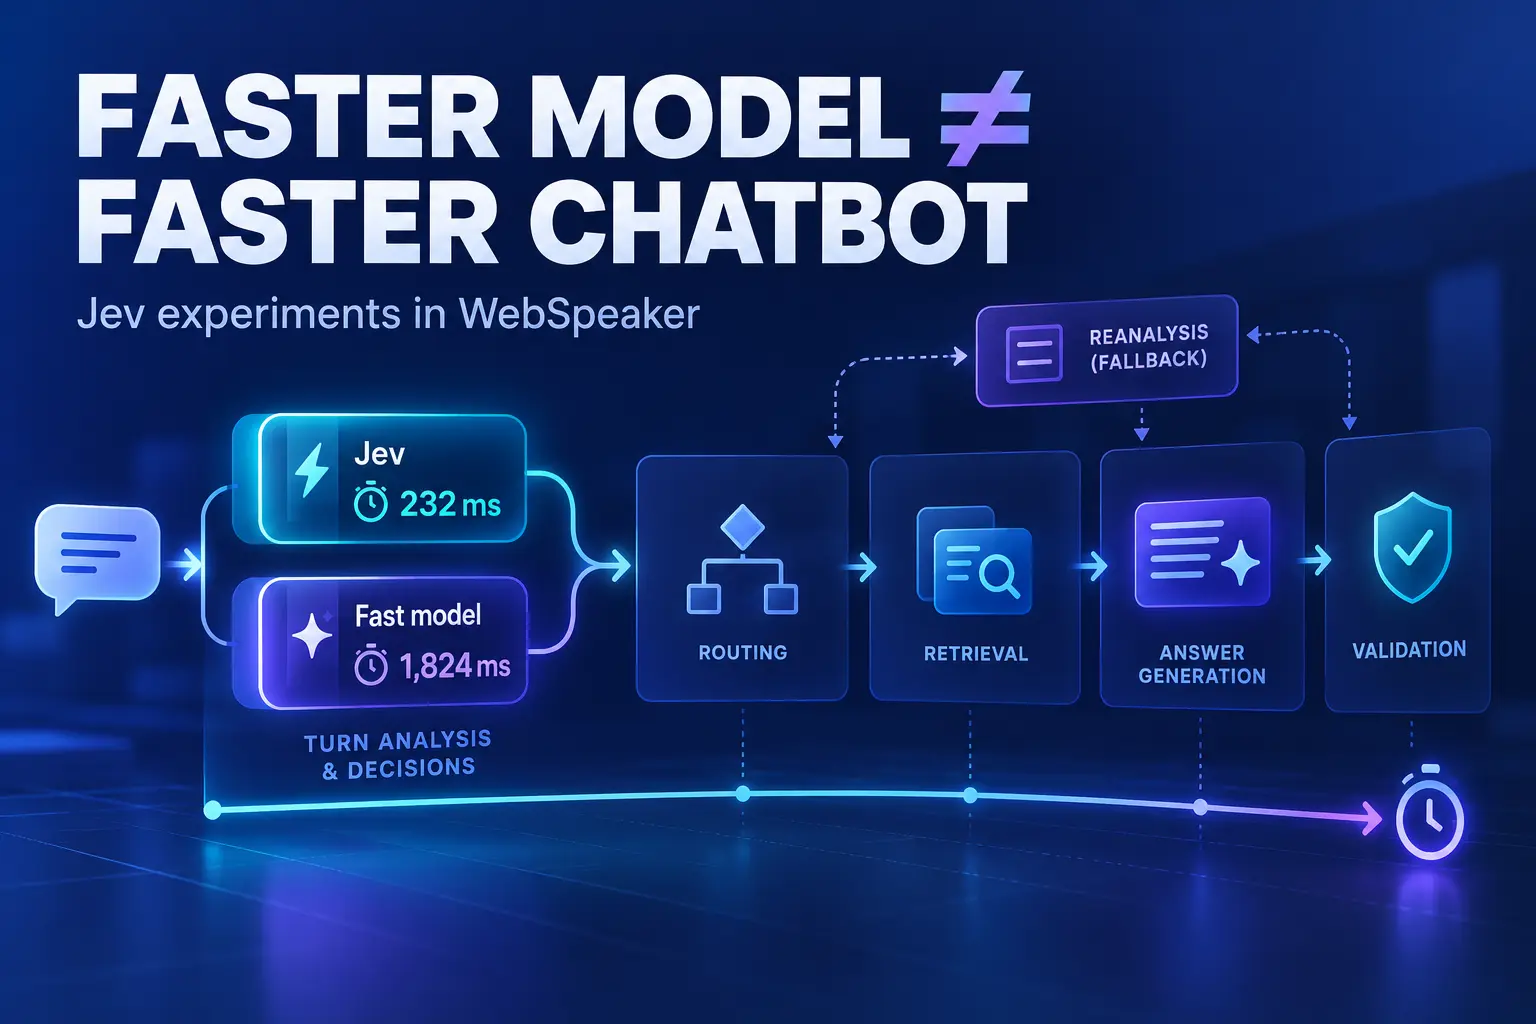
Szybszy model, wolniejszy chatbot. Czego nauczył nas eksperyment z Jev
W skrócie: testowaliśmy Jev, nowy model do błyskawicznych decyzji, jako sposób na przyspieszenie WebSpeakera. Jev decydował szybko i nieco trafniej niż model, którego używamy dziś. Mimo to w każdym sprawdzonym wariancie odwiedzający czekał na odpowiedź dłużej. Nie wdrożyliśmy go. Najważniejsza lekcja: w produkcie opartym na AI liczy się czas i jakość całej rozmowy, a nie wynik pojedynczego modelu w benchmarku.
Skąd pomysł
WebSpeaker to chatbot, który firmy umieszczają na swoich stronach, żeby odpowiadał odwiedzającym na podstawie treści strony i dokumentacji. Każda odpowiedź zaczyna się od kilku decyzji: czy trzeba przeszukać materiały firmy, czego w nich szukać, czy rozmówca chce kontaktu z człowiekiem. Dopiero potem chatbot pisze odpowiedź i sprawdza ją przed wysłaniem.
Te wstępne decyzje podejmuje dziś model Gemini, który przy okazji przygotowuje zapytania do wyszukiwarki i notatki z przebiegu rozmowy. Firma TypeSafe AI udostępniła Jev, model zaprojektowany do szybkich, „odruchowych” wyborów z podanej listy zamiast pisania tekstu. W pierwszym teście mediana czasu jednej decyzji Jev wyniosła 232 ms, a przygotowania pełnego planu przez Gemini 1824 ms. Nie były to te same zadania, bo Gemini robiło więcej, ale różnica była na tyle duża, że postanowiliśmy sprawdzić podział pracy: Jev decyduje, Gemini pisze.
Co sprawdziliśmy
Przeprowadziliśmy cztery próby na syntetycznych pytaniach po polsku i angielsku. Żadne dane klientów nie trafiły do testowanego modelu.
Sama decyzja. Czy wyszukać informacje, odpowiedzieć od razu, czy przekazać rozmowę człowiekowi? Jev i Gemini były równie trafne: 96,7% na 60 pytaniach. Jev był znacznie szybszy, ale wykonywał tylko część pracy.
Decyzje Jev zamiast decyzji Gemini. Podmieniliśmy część decyzji w planie Gemini na decyzje Jev i przepuściliśmy rozmowę przez cały chatbot. Jev częściej wybierał to, czego oczekiwaliśmy (91% wobec 87%), ale plan nieco częściej wymagał dodatkowej weryfikacji przez inny model. Decyzja trafna w oderwaniu może nie pasować do reszty planu, na przykład „trzeba przeszukać dokumentację”, gdy nikt nie przygotował zapytania.
Najpierw Jev, potem Gemini. Gemini miało mniej pracy i kończyło szybciej, ale najpierw trzeba było poczekać na Jev. Przy większym pakiecie decyzji jego czas wzrósł z 232 do 872 ms. Etap analizy się wydłużył, a cała odpowiedź przychodziła średnio o około 27% później.
Jev i Gemini równolegle. Tu etap analizy wreszcie był szybszy: o 9% w typowym żądaniu i o 24% w tych wolniejszych. Trafność decyzji też była wyższa (92% wobec 87%). A jednak cała odpowiedź przychodziła o około 22% później, a w jednym przypadku chatbot udzielił odpowiedzi wewnętrznie sprzecznej.
Dlaczego szybszy etap nie dał szybszej odpowiedzi
Analiza pytania to tylko jeden z kilku kroków. Po niej następuje wyszukiwanie, czasem dodatkowa weryfikacja planu, pisanie odpowiedzi i jej kontrola. Oszczędność 151 ms na analizie ginęła w tym, co działo się dalej.
A dalej działo się coś innego niż zwykle. Po zmianie podziału pracy chatbot w części rozmów wybierał inną ścieżkę, szukał w innym zakresie albo uruchamiał dodatkową weryfikację. Gdy dwa modele pracują równolegle, żaden nie wie, co zdecydował drugi: Gemini pisze zapytanie do wyszukiwarki, nie wiedząc, czy Jev w ogóle uznał wyszukiwanie za potrzebne. Na tak małej próbie nie potrafimy wskazać, która z tych przyczyn ważyła najwięcej, ale kierunek jest wyraźny.
Dzieląc pracę między modele, zmieniasz to, co każdy z nich wie. Szybkość jednego elementu nie mówi nic o szybkości całości.
Co to oznacza dla klientów WebSpeakera
Nowy model trafia do WebSpeakera dopiero wtedy, gdy poprawia jakość, czas lub koszt całej rozmowy, nie pogarszając pozostałych. Szybki wynik w izolowanym teście to dla nas punkt wyjścia do sprawdzenia, a nie powód do wdrożenia.
Równie ważne jest to, co dzieje się z danymi. Zanim nowy dostawca modelu zobaczy pytania odwiedzających, sprawdzamy, gdzie je przetwarza, jak długo przechowuje, czy używa ich do trenowania modeli i jak działa pod rzeczywistym obciążeniem. Jev nie przeszedł jeszcze tego etapu, bo odpadł wcześniej: nie trafił do rozmów klientów, a eksperymenty pozostały poza kodem produkcyjnym.
Czy wrócimy do Jev?
Możliwe. To był pilotaż na ośmiu scenariuszach testowych, po trzy powtórzenia każdy, i nie ocenialiśmy systematycznie jakości wszystkich odpowiedzi końcowych. To za mało, żeby przesądzać w którąkolwiek stronę. Nie policzyliśmy też jeszcze pełnego kosztu obu wariantów.
Wrócimy, jeśli na większym i bardziej zróżnicowanym zestawie pytań podział pracy da powtarzalnie szybszą odpowiedź całego chatbota, niższy koszt i nie pogorszy jakości, a dostawca przejdzie weryfikację w zakresie danych.