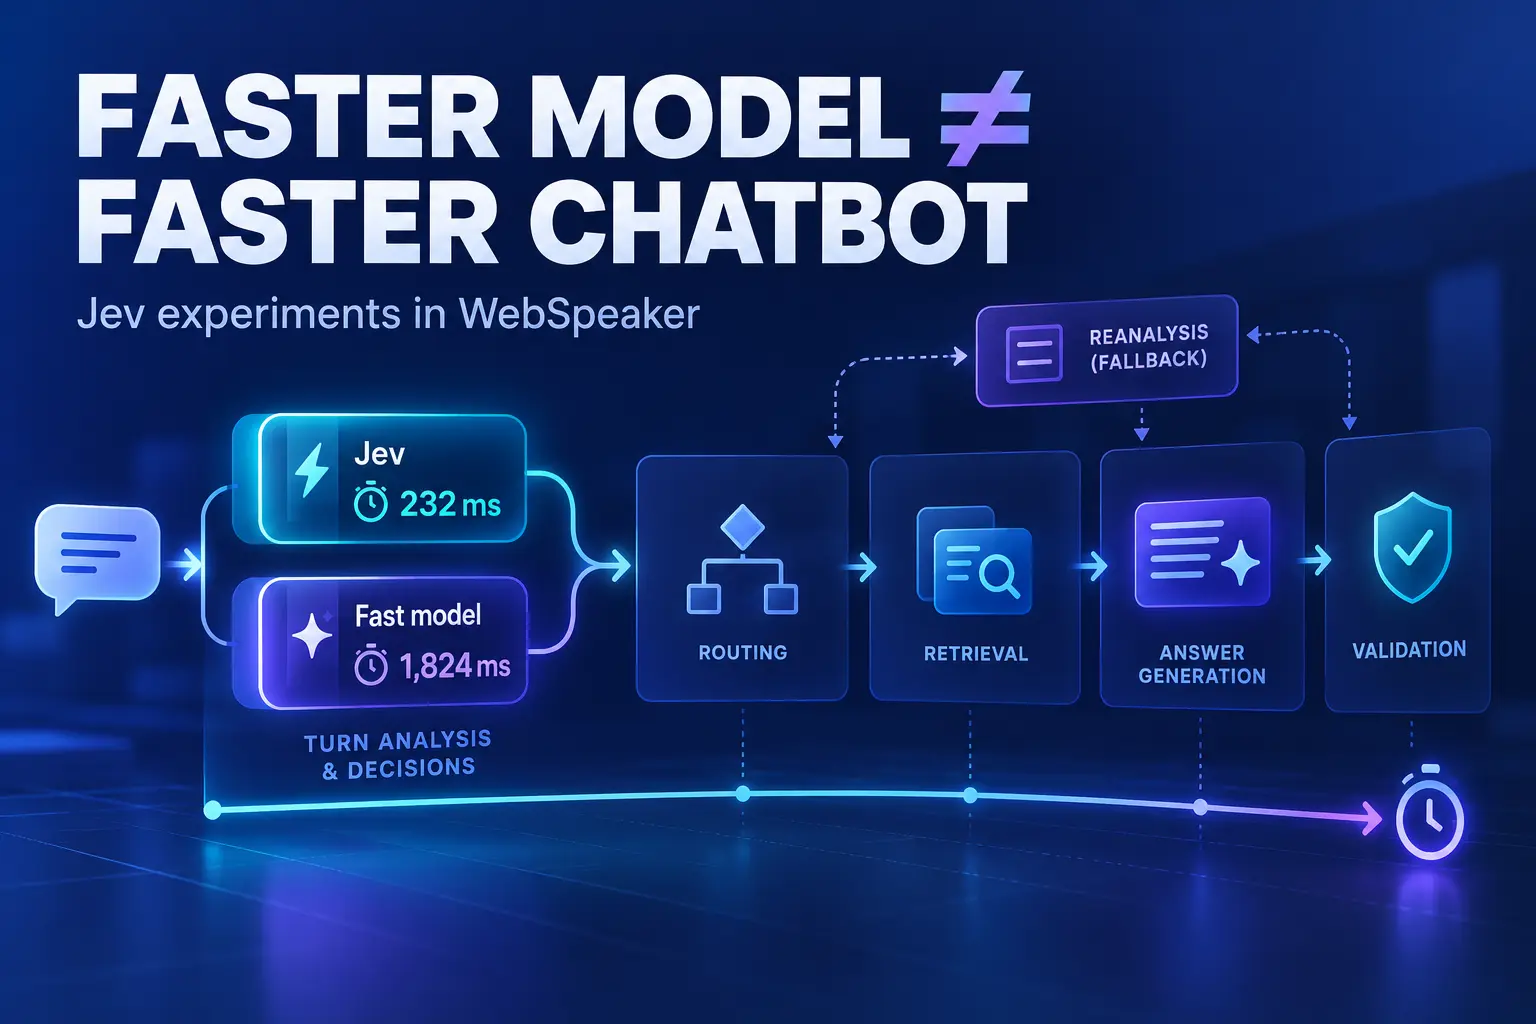
Schnelleres Modell, langsamerer Chatbot. Was wir aus dem Jev-Experiment gelernt haben
Kurz gesagt: Wir haben Jev, ein neues Modell für blitzschnelle Entscheidungen, als mögliche Beschleunigung für WebSpeaker getestet. Jev entschied schnell und etwas treffender als das Modell, das wir heute nutzen. Trotzdem warteten Besucher in jeder getesteten Variante länger auf eine Antwort. Wir haben Jev nicht eingeführt. Die wichtigste Erkenntnis: Bei einem KI-Produkt zählen Dauer und Qualität des gesamten Gesprächs, nicht das Benchmark-Ergebnis eines einzelnen Modells.
Wie wir auf die Idee kamen
WebSpeaker ist ein Chatbot, den Unternehmen auf ihren Websites einbinden, um Fragen von Besuchern anhand der Website-Inhalte und der Dokumentation zu beantworten. Jede Antwort beginnt mit einigen Entscheidungen: Muss der Chatbot die Materialien des Unternehmens durchsuchen? Wonach soll er suchen? Möchte der Besucher mit einem Menschen sprechen? Erst danach formuliert und prüft der Chatbot seine Antwort, bevor er sie versendet.
Heute trifft Gemini diese ersten Entscheidungen und erstellt zugleich Suchanfragen und Notizen zum Gesprächsverlauf. TypeSafe AI hat Jev veröffentlicht: ein Modell, das schnell und beinahe reflexartig aus einer vorgegebenen Liste auswählt, statt Texte zu schreiben. Im ersten Test lag die mediane Dauer einer einzelnen Jev-Entscheidung bei 232 ms; Gemini brauchte 1.824 ms, um den vollständigen Plan zu erstellen. Die Aufgaben waren nicht gleich — Gemini leistete mehr. Der Unterschied war aber groß genug, um eine Arbeitsteilung zu prüfen: Jev entscheidet, Gemini schreibt.
Was wir getestet haben
Wir haben vier Versuche mit synthetischen Fragen auf Polnisch und Englisch durchgeführt. Keine Kundendaten wurden an das getestete Modell übermittelt.
Eine einzelne Entscheidung. Soll der Chatbot Informationen suchen, sofort antworten oder das Gespräch an einen Menschen übergeben? Jev und Gemini waren gleich treffsicher: 96,7 % bei 60 Fragen. Jev war deutlich schneller, übernahm aber nur einen Teil der Arbeit.
Jevs Entscheidungen statt Geminis Entscheidungen. Wir ersetzten einige Entscheidungen in Geminis Plan durch Jevs Ergebnisse und ließen die Anfrage durch den gesamten Chatbot laufen. Jev wählte häufiger das, was wir erwarteten (91 % gegenüber 87 %). Der Plan benötigte jedoch etwas häufiger eine zusätzliche Prüfung durch ein anderes Modell. Eine für sich genommen richtige Entscheidung muss nicht zum Rest des Plans passen: etwa „Dokumentation durchsuchen“, wenn niemand eine Suchanfrage vorbereitet hat.
Erst Jev, dann Gemini. Gemini hatte weniger Arbeit und war schneller fertig, musste aber zuerst auf Jev warten. Bei einem größeren Bündel von Entscheidungen stieg Jevs mediane Aufrufdauer von 232 auf 872 ms. Die Analyse dauerte länger, und die vollständige Antwort traf im Mittel etwa 27 % später ein.
Jev und Gemini parallel. Hier war die Analyse endlich schneller: um 9 % bei einer typischen Anfrage und um 24 % bei den langsameren. Auch die Trefferquote bei den Entscheidungen war höher (92 % gegenüber 87 %). Trotzdem kam die vollständige Antwort etwa 22 % später. In einem Fall gab der Chatbot zudem eine in sich widersprüchliche Antwort.
Warum eine schnellere Etappe keine schnellere Antwort brachte
Die Analyse der Frage ist nur einer von mehreren Schritten. Danach folgen die Suche, manchmal eine zusätzliche Prüfung des Plans, das Formulieren der Antwort und ihre Kontrolle. Die bei der Analyse eingesparten 151 ms gingen bei den nachfolgenden Schritten wieder verloren.
Und diese Schritte verliefen nicht immer wie gewohnt. Durch die andere Arbeitsteilung wählte der Chatbot in manchen Gesprächen einen anderen Weg, suchte in anderem Umfang oder startete eine zusätzliche Prüfung. Wenn zwei Modelle parallel arbeiten, weiß keines, was das andere entschieden hat: Gemini schreibt eine Suchanfrage, ohne zu wissen, ob Jev eine Suche überhaupt für nötig hielt. Bei dieser kleinen Stichprobe können wir nicht sagen, welcher dieser Faktoren am schwersten wog. Die Richtung des Ergebnisses ist aber klar.
Wer die Arbeit zwischen Modellen aufteilt, verändert, was jedes Modell weiß. Die Geschwindigkeit eines Bausteins sagt nichts über die Geschwindigkeit des gesamten Systems aus.
Was das für WebSpeaker-Kunden bedeutet
Ein neues Modell kommt bei WebSpeaker erst zum Einsatz, wenn es Qualität, Zeit oder Kosten des gesamten Gesprächs verbessert, ohne die anderen Bereiche zu verschlechtern. Ein schnelles Ergebnis in einem isolierten Test ist für uns ein Anlass zur Prüfung, kein Grund für eine Einführung.
Ebenso wichtig ist der Umgang mit Daten. Bevor ein neuer Modellanbieter die Fragen von Besuchern sieht, prüfen wir, wo er sie verarbeitet, wie lange er sie speichert, ob er sie zum Training von Modellen nutzt und wie er unter tatsächlicher Last arbeitet. Jev hat diesen Schritt noch nicht erreicht: Es kam nicht in Kundengesprächen zum Einsatz, und die Experimente blieben außerhalb des Produktivcodes.
Werden wir zu Jev zurückkehren?
Möglicherweise. Das war ein Pilotversuch mit acht Testszenarien, die wir jeweils dreimal wiederholt haben. Wir haben die Qualität nicht bei allen endgültigen Antworten systematisch bewertet. Das reicht nicht für ein abschließendes Urteil. Auch die Gesamtkosten beider Varianten haben wir noch nicht berechnet.
Wir kommen darauf zurück, wenn die Arbeitsteilung bei einer größeren und vielfältigeren Auswahl von Fragen wiederholt zu einer schnelleren vollständigen Antwort bei geringeren Kosten und ohne Qualitätsverlust führt — und wenn der Anbieter unsere Prüfung zum Umgang mit Daten besteht.